Claude Code vs. OpenAI Codex: cómo elegir en una multinacional
Por Alejandro Ramiro Sechi
Elegir un agente de programación para una multinacional exige evaluar cómo trabaja dentro de la empresa: repositorios, identidad, red, datos, revisiones y presupuesto.
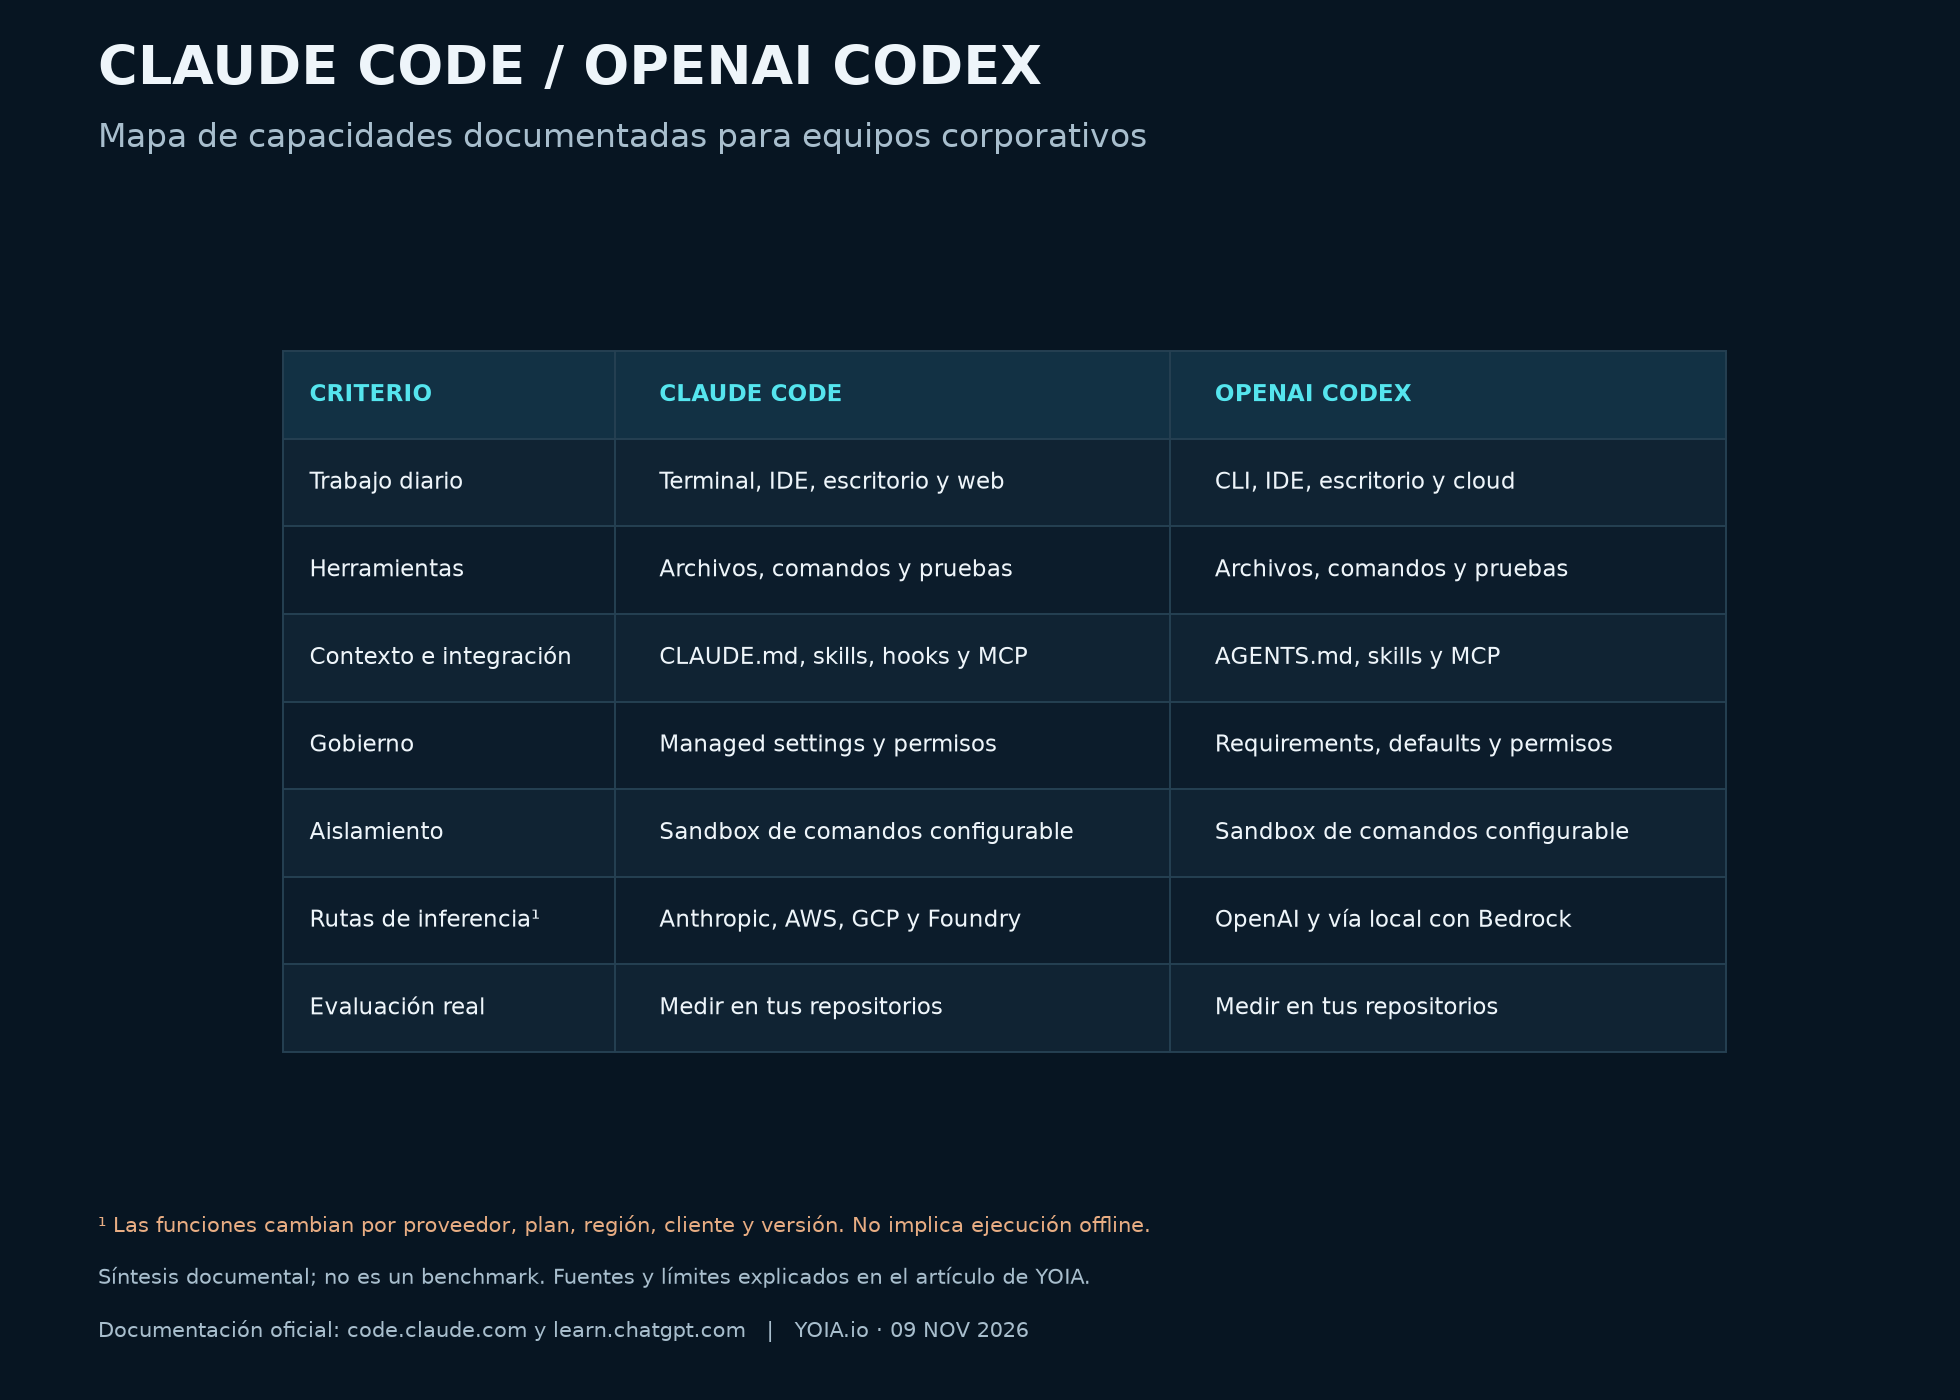
Comparativa editorial de YOIA · documentación consultada el 9 de noviembre de 2026. Analizamos herramientas y despliegue corporativo, sin atribuir una victoria universal a ninguno. No hemos ejecutado un benchmark comparativo en repositorios empresariales; las gráficas muestran una síntesis documental y una propuesta de evaluación.
1. TRABAJO DIARIO DEL PROGRAMADOR
Claude Code permite leer y modificar archivos y ejecutar comandos desde terminal, IDE, escritorio y web. Sus extensiones incluyen CLAUDE.md para convenciones del proyecto, skills para procedimientos reutilizables, hooks para automatización y MCP para herramientas externas.
Fuentes: https://code.claude.com/docs/en/overview y https://code.claude.com/docs/en/features-overview
Codex ofrece CLI, extensión de IDE, escritorio y tareas cloud. En Codex Cloud, cada tarea dispone de un espacio de trabajo y el equipo puede revisar cambios, pedir ajustes y abrir una pull request. MCP conecta herramientas e información de otros sistemas; AGENTS.md permite incorporar instrucciones del repositorio.
Fuentes: https://learn.chatgpt.com/docs/cloud y https://learn.chatgpt.com/docs/extend/mcp
Mi valoración: ambos merecen un piloto con bugs reales, refactorizaciones y pruebas del equipo. La disponibilidad de una función no demuestra por sí sola que resuelva mejor vuestro código.
2. GOBIERNO: MÁS ALLÁ DE DAR LICENCIAS
Claude Code documenta managed settings que prevalecen sobre la configuración del usuario o del proyecto, con mecanismos de distribución corporativa. Sus controles permiten gestionar permisos y configuración; el sandbox de comandos aporta aislamiento de archivos y red cuando está habilitado.
Fuentes: https://code.claude.com/docs/en/managed-settings y https://code.claude.com/docs/en/security
Codex distingue requirements obligatorios y defaults modificables. Los administradores pueden restringir opciones admitidas de aprobación, sandbox y red en los clientes compatibles. Los permisos del workspace, del runtime local, de la API y del repositorio son capas distintas: conceder acceso en una no concede automáticamente acceso en las demás.
Fuentes: https://learn.chatgpt.com/docs/enterprise/managed-configuration y https://learn.chatgpt.com/docs/enterprise/roles-and-workspace-permissions
Aplicación práctica: verificar con una cuenta de desarrollador que las restricciones se cumplen en Windows, macOS y los runners utilizados. El contexto escrito en CLAUDE.md o AGENTS.md ayuda a trabajar; no sustituye controles de acceso.
3. NUBE, IDENTIDAD Y MULTINACIONALES
Claude Code documenta rutas directas con Anthropic y opciones mediante Amazon Bedrock, Google Cloud y Microsoft Foundry. La identidad, la facturación y las funciones dependen de la vía elegida.
Fuente: https://code.claude.com/docs/en/third-party-integrations
Codex también documenta uso local con modelos OpenAI mediante Amazon Bedrock y autenticación AWS. Esa ruta tiene limitaciones: no equivale a Codex Cloud ni incluye automáticamente funciones de workspace como RBAC, analítica o Compliance API. Comprobad la matriz de disponibilidad antes de diseñar el despliegue.
Fuente: https://learn.chatgpt.com/docs/amazon-bedrock
Mi valoración: si la empresa ya tiene contratación, identidad y observabilidad en una nube concreta, conviene probar esa vía. Ejecutar el cliente localmente no significa que la inferencia sea local u offline. La residencia de datos requiere revisar modelo, región, enrutamiento y contrato, además del producto.
4. OBSERVABILIDAD Y COSTE REAL
Claude Code permite exportar uso, costes y actividad de herramientas mediante OpenTelemetry. En Codex, la configuración administrada documenta controles de telemetría; las funciones de administración y analítica dependen de la vía de acceso.
Fuentes: https://code.claude.com/docs/en/monitoring-usage y https://learn.chatgpt.com/docs/enterprise/managed-configuration
Para comparar presupuestos, propongo medir coste por cambio aceptado: licencias y consumo, infraestructura atribuible y tiempo de revisión/corrección, divididos entre cambios que superan los criterios de aceptación. Separad además los costes iniciales de integración y formación. Comparar solo precio por asiento o tokens deja fuera trabajo relevante.
5. UN PILOTO QUE AYUDE A DECIDIR
Propuesta de YOIA: cuatro semanas, dos equipos representativos y tareas emparejadas por dificultad. Alternar herramientas y orden, utilizar ramas separadas, registrar modelo y versión, fijar presupuestos y mantener los mismos criterios de aceptación. Evitar repetir exactamente una tarea ya resuelta sin controlar el efecto de aprendizaje.
Medir: porcentaje de tareas aceptadas, tiempo hasta aceptación, minutos de revisión, fallos detectados por pruebas, defectos posteriores y coste total por cambio. Registrar también bloqueos de permisos y esfuerzo de integración. No usar líneas de código generadas como indicador principal.
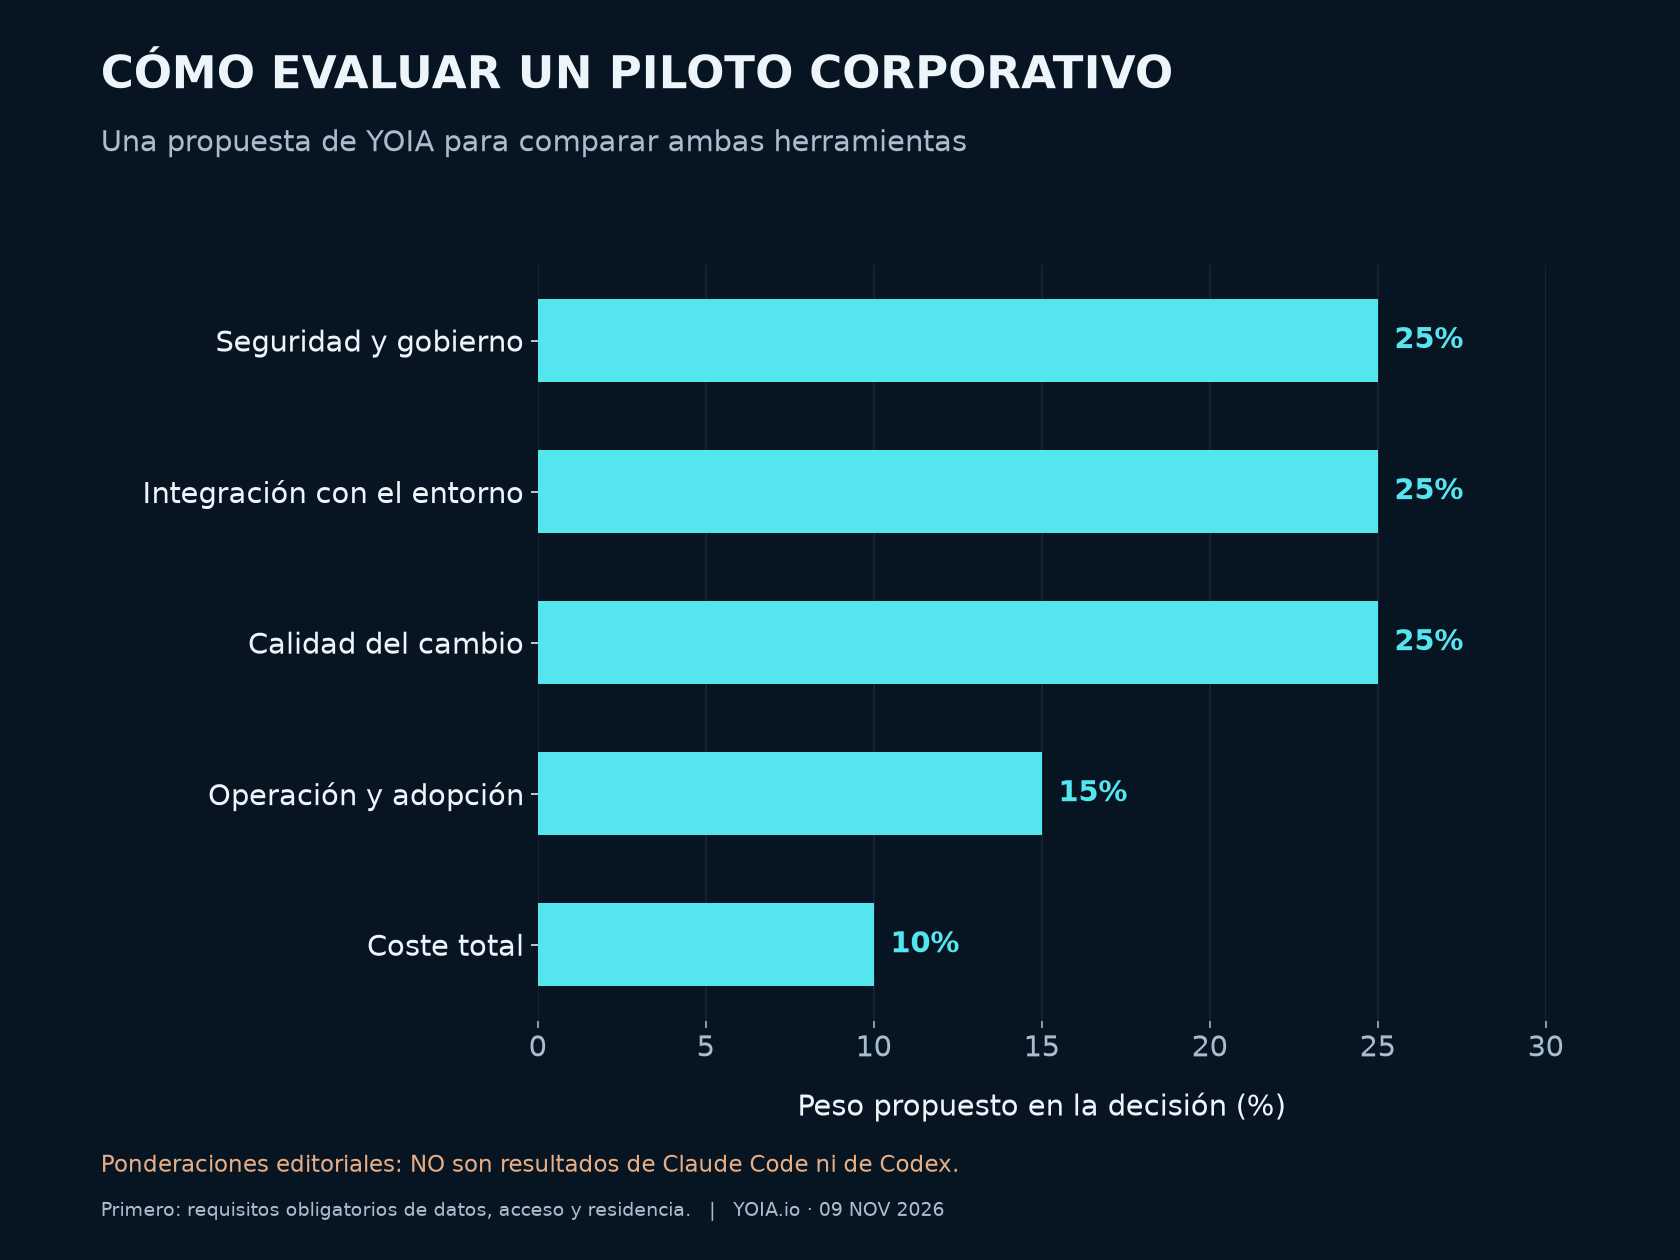
La gráfica propone estos pesos: seguridad y gobierno 25%; integración 25%; calidad 25%; operación y adopción 15%; coste 10%. Son criterios editoriales, NO puntuaciones de rendimiento. Los requisitos obligatorios de datos, identidad y residencia deben cumplirse antes de ponderar resultados; no se compensan con una mejor nota en otra categoría.
¿CUÁL ELEGIRÍA?
Como hipótesis de partida, priorizaría Claude Code cuando sus rutas de proveedor y su configuración encajen mejor con la plataforma existente. Priorizaría Codex cuando el flujo de trabajo con OpenAI, sus entornos cloud y su administración encajen mejor con el equipo. Si ambos cumplen los requisitos, decidiría con resultados del piloto y coste por cambio aceptado. Mantener ambos puede tener sentido, incluyendo el coste de operar dos herramientas.
Para una multinacional, la recomendación depende del entorno concreto. Ninguna herramienta sustituye las revisiones de código, las pruebas y la responsabilidad del equipo sobre lo que despliega.
Las tres imágenes incluyen una portada ilustrativa generada con IA, una matriz documental y la gráfica de ponderaciones propuesta por YOIA. No representan mediciones de productividad.
¿Qué os frena más para desplegar agentes de programación: seguridad, integración con sistemas internos, coste o calidad del código?
YOIA.io · IA aplicada a procesos, equipos y negocio.